 Login AI
Разработка систем распознавания речи
Собираем распознавание речи под ваш домен: телефонные звонки и встречи, диаризация, словари терминов и замер WER на реальных записях.
Речь в текст с учётом домена: термины, имена и несколько говорящих.
Стоимость
от 1 500 000 ₽
за проект
Это нижняя граница проекта. Точную смету считаем после брифа: она зависит от объёма и числа интеграций.
Возможности
Домен и словарь
Подключаем словарь терминов и имён, чтобы модель не путала профессиональную лексику.
Диаризация
Разделяем говорящих в звонке или встрече, а не сваливаем реплики в один поток.
Шум и каналы
Обрабатываем телефонию, микрофоны и плохую связь отдельно, своим набором настроек под каждый канал.
WER на ваших записях
Качество меряем на ваших записях, а не на общей метрике вендора.
От заявки до результата
1
Аудит записей
Слушаем реальные записи: каналы, шум, акцент и словарь, который нужно поддержать.
2
Схема словарей и диаризации
Фиксируем словарь терминов, правила разделения говорящих и требования к формату.
3
Обучение и адаптация
Дообучаем модель под домен и канал, замеряем WER на отложенных записях.
4
Запуск в поток
Подключаем распознавание к очереди звонков и настраиваем разбор ошибок.
Проверьте, подойдёт ли вам
Подходит
Есть записи для оценки
Несколько часов реального аудио дают честный WER до старта.
Устойчивый канал связи
Качество микрофонов и линии стабильно: модель не переучивается на случайном шуме.
Не подходит
Критичные имена и суммы
Там, где ошибка в цифре недопустима, распознавание требует ручной проверки.
Нет словаря терминов
Без списка терминов и имён модель уверенно пишет неверное слово.
Что вы получаете
−30%
WER после адаптации словаря
Распознавание адаптировали под термины и имена, диаризация разделяла оператора и клиента.
WER 8%
Точность на домене
WER на отложенных записях домена опускается до восьми процентов после адаптации словаря и канала связи.
1,2 сек
Быстрая расшифровка
Расшифровка минутной записи занимает 1,2 секунды на сервере, поэтому стенограмма готова почти сразу после звонка.
До 3 голосов
Разделение говорящих
Диаризация ведёт до трёх голосов на дорожку, поэтому в стенограмме видно, где говорит оператор, а где клиент.
Механизм работы
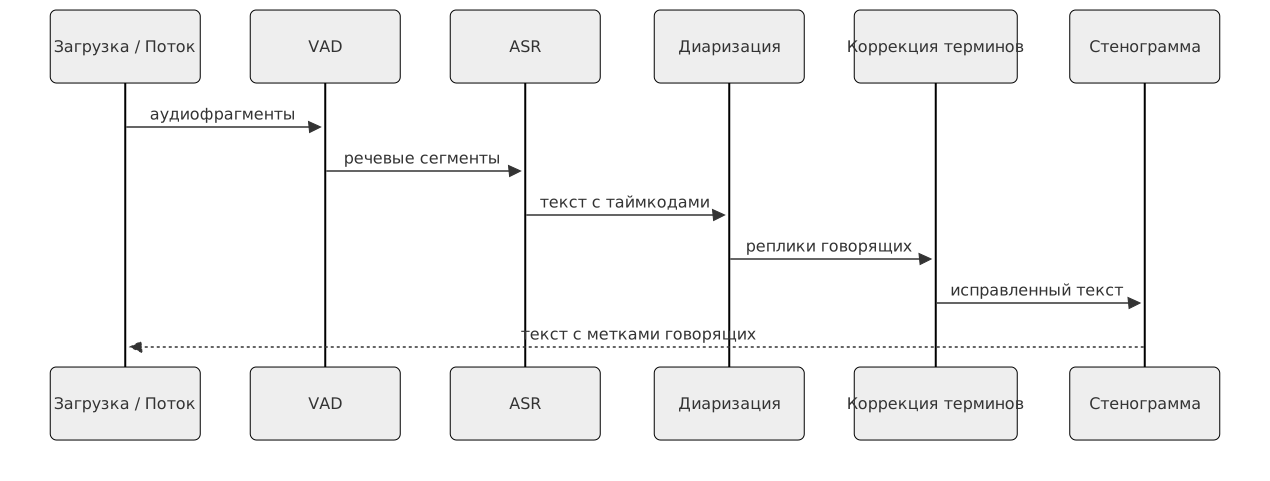
Словарь терминов и имён подключается до обучения
Словарь терминов и имён подключается до обучения, поэтому модель уверенно распознаёт редкую лексику: названия продуктов, фамилии клиентов и профессиональные сокращения звучат точно.
Диаризация разделяет говорящих
Диаризация разделяет говорящих на дорожки, поэтому стенограмма звонка читается как диалог с репликами оператора и клиента и упрощает разбор качества по каналам.
Качество зависит от канала
Качество зависит от канала, поэтому телефонные записи и микрофон переговорной обрабатываются своими настройками: команда получает точный текст для каждого источника звука.
WER считается на ваших записях
WER считается на ваших записях по домену, поэтому замер отражает реальную точность: команда видит качество на своих звонках и сравнивает его до и после адаптации.
Где решение упирается
- 01
Имена и суммы
Похожие числа и фамилии путаются, поэтому имена, суммы и артикулы остаются слабым местом. Словарь терминов и имён снижает число таких ошибок.
- 02
Шум и перекрытие речи
Там, где говорят одновременно, теряются слова. Шум и перекрытие речи режут точность, поэтому пишем на канал с меньшими помехами.
- 03
Смена домена
Модель на встречах теряет качество на звонках, поэтому смена домена требует адаптации. Домен задаёт словарь и настройки распознавания.
- 04
Адаптация к терминам
Речь без адаптации к терминам даёт уверенные, но неверные расшифровки. Адаптация к терминам и проверка фактов снижают риск такой ошибки.
Что входит в распознавание
Что входит в распознавание
Модель обучается на ваших записях: канал связи, акцент и словарь домена задают настройки распознавания.
Словарь терминов и имён подключается до обучения, поэтому редкая лексика и фамилии клиентов распознаются уверенно.
Как проверяем качество
Как проверяем качество
WER считаем на отложенных записях отдельно по каналам связи и типам речи, чтобы видеть точность на каждом источнике звука.
Диаризация разделяет говорящих, и стенограмма приходит с метками оператора и клиента для разбора качества.
Технологии
Технологии, которые мы используем в работе, и их роль в проекте.
Аудио и модели
Аудио хранится в MinIO, модели распознавания обучаются на PyTorch, инференс идёт на vLLM, а очередь обработки — в Kafka.
Калькулятор стоимости
Это ориентировочный диапазон, а не коммерческое предложение. Точную смету подготовим после брифа: она зависит от объёма и числа интеграций.
Языки
Доменная адаптация
Потоковый режим
Диаризация
Дополнительно
Поддержка
Первый год: обновления и мониторинг, ответ за 2 рабочих дня.
Услуга
Разработка систем распознавания речи
В смету входит работа команды. Оборудование, лицензии сторонних сервисов и командировки добавляем по согласованию.
Расчётная стоимость
1,8 млн. ₽
Срок работ
4 нед.
Частые вопросы
Записи уходят наружу?
По умолчанию нет: распознавание разворачивается в вашем контуре. Внешний сервис — только если вы сами это разрешите.
Что с несколькими говорящими?
Диаризация разделяет голоса на дорожки. Точность падает, когда говорят одновременно, и это видно в замерах.
Как считается качество?
WER на ваших отложенных записях по домену, отдельно по каналам и типам речи, а не общей цифрой вендора.
Сколько занимает адаптация?
Первая адаптация под домен — от трёх недель, включая разметку и замер на реальных записях.
Что берут вместе с этой услугой
Связанные услуги
В составе решений
Примеры внедрений
−70 %
Время обработки обращения
Готовы обсудить задачу?
Оставьте заявку – вернёмся с предложением и предварительной оценкой.
Связаться с нами