 Login AI
Проектирование ИИ-инфраструктуры
Проектирование и развертывание вычислительной инфраструктуры для работы искусственного интеллекта. Внедрение систем семантического поиска, оптимизация расходов на инференс и защита коммерческой тайны.
Интеграция больших языковых моделей в закрытые корпоративные контуры с гарантией защиты данных.
Стоимость
от 2 500 000 ₽
за проект
Это нижняя граница проекта. Точную смету считаем после брифа: она зависит от объёма и числа интеграций.
Возможности
Защита от галлюцинаций
Жесткая изоляция ИИ-моделей в рамках верифицированных локальных документов компании.
Контроль операционных затрат
Эффективное семантическое кэширование, предотвращающее избыточную повторную отправку токенов.
Безопасность данных
Развертывание поисковых контуров и баз данных внутри приватного периметра организации.
Гибридный поиск
Одновременный учет смыслового сходства информации и точных совпадений по ключевым идентификаторам.
От заявки до результата
1
Аудит данных
Оценка структуры, объема и качества корпоративной информации, подлежащей индексации.
2
Проектирование контура
Выбор и развертывание векторных СУБД, настройка параметров HNSW-индексов и чанкинга.
3
Сборка пайплайна
Интеграция систем кэширования, механизмов переранжирования и промпт-инжиниринга.
4
Тестирование и запуск
Запуск сквозного трейсинга, верификация отсутствия галлюцинаций и фиксация SLA.
Проверьте, подойдёт ли вам
Подходит
Предприятия с развитыми базами знаний
Организации со значительными объемами закрытых внутренних регламентов, технической документации и архивов.
Финтех и юридические платформы
Продукты и внутренние сервисы, требующие автоматического анализа сложных договоров с абсолютной точностью.
Крупные e-commerce агрегаторы
Торговые площадки, внедряющие умный мультиязычный поиск по миллионам распределенных карточек товаров.
Службы клиентской поддержки
Контуры автоматизации первой и второй линии ответов пользователям на основе накопленной истории тикетов.
Не подходит
Компании без накопленных данных
Новые проекты, у которых нет своей текстовой базы знаний, регламентов или истории процессов.
Линейные сценарии автоматизации
Системы взаимодействия, где для полного закрытия задач достаточно жесткого дерева условий программирования.
Продукты без бюджета на инфраструктуру
Ранние прототипы, планирующие использовать исключительно публичные API без локального кэширования информации.
Динамически меняющиеся интерфейсы
Сервисы обработки транзакций или котировок в реальном времени, где данные устаревают каждую секунду.
Что вы получаете
−80%
расходов на токены LLM
Подтвержденный результат оптимизации ИИ-инфраструктуры за счет внедрения семантического кэширования и контроля контекстных окон.
Что входит в поставку
Очистка и индексация
Очистка и индексация: собираем неструктурированные данные, чистим дубли и строим векторный индекс с метаданными.
Гибридный поиск
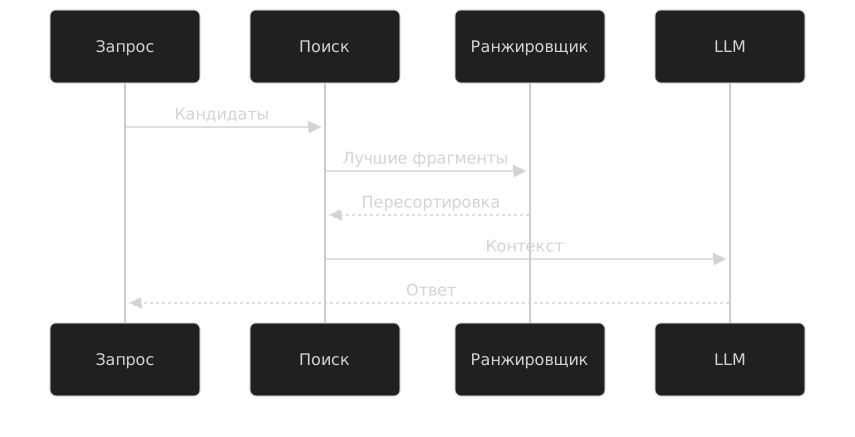
Векторный и полнотекстовый поиск работают вместе, а результат переранжируем, чтобы ответ опирался на точные фрагменты.
Семантический кэш
Семантический кэш отвечает на повторные вопросы из памяти, поэтому стоимость внешних вызовов падает.
Трассировка и бюджет
Трассировка и бюджет: видим путь ответа и стоимость по шагам, а лимиты и алерты держат расход под контролем.
Механизм работы
Анализ и предварительная обработка
Анализ и предварительная обработка неструктурированных текстовых массивов, файлов и внутренней документации идёт первым этапом. Мы приводим данные к единому виду, поэтому индекс строится на чистом и полном материале.
Очистка исходных данных
Очистка исходных данных убирает дубликаты, системный мусор и некорректные символы перед индексацией. Мы приводим исходные данные к единому виду, поэтому поиск получает ровный и точный материал для работы.
Разработка стратегий нарезки
Разработка стратегий нарезки делит документы на логические фрагменты, чтобы сохранить контекст и смысл. Мы подбираем размер фрагмента под ваши документы, поэтому ответы опираются на связанные куски текста.
Генерация векторных эмбеддингов
Генерация векторных эмбеддингов высокой плотности идёт на оптимизированных моделях преобразования текстов. Модели настроены на ваши данные, поэтому векторное представление точно отражает смысл документов и язык отрасли.
Проектирование геометрии HNSW-графов
Проектирование геометрии HNSW-графов задаёт структуру связей в векторных хранилищах и ускоряет поиск. Мы настраиваем параметры графа под ваш объём данных, поэтому нужный фрагмент находится за миллисекунды.
Автоматическое обновление индексов
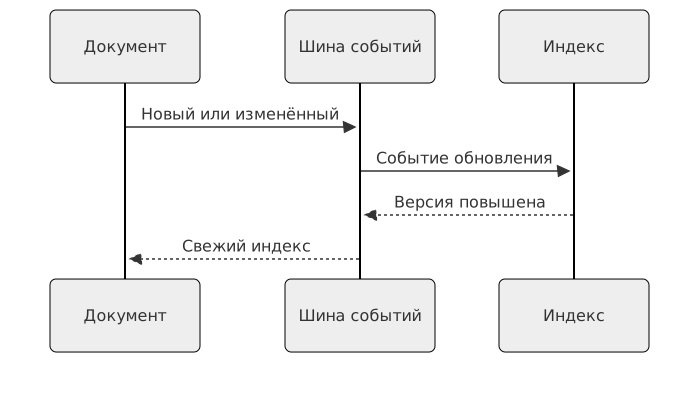
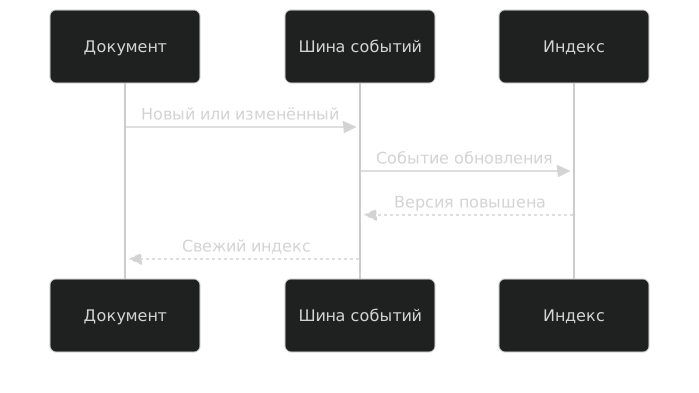
Настройка автоматического обновления индексов срабатывает при изменении или добавлении исходных документов. Индексы обновляются по событию, поэтому поиск видит свежие данные и выдаёт актуальные ответы без ручных запусков.
Семантическое кэширование
Семантическое кэширование перехватывает частые повторные запросы и отвечает мгновенно из памяти. Кэш определяет близость смысла вопросов, поэтому система экономит на внешних вызовах и держит ответ быстрым.
Переранжирование результатов
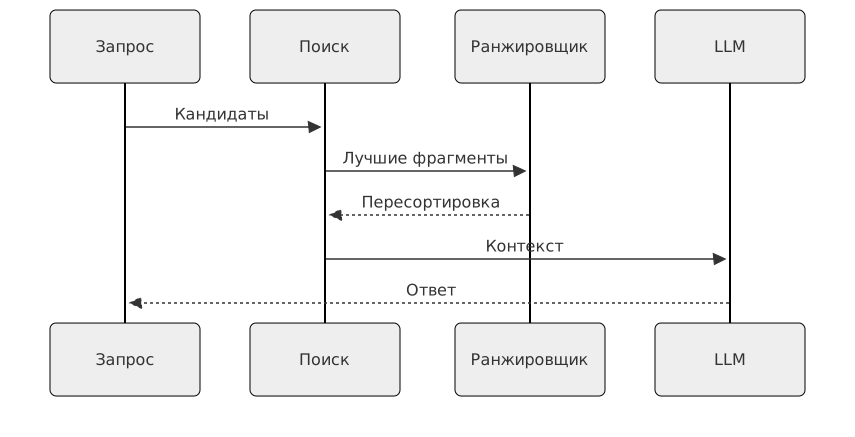
Переранжирование результатов поиска поднимает наверх самые релевантные фрагменты и повышает точность ответов. Алгоритм переранжирования сравнивает кандидатов, поэтому модель опирается на лучшие куски контекста на сложных запросах.
Системные инструкции и шаблоны
Разработка и тестирование системных инструкций и шаблонов промпт-инжиниринга задаёт модели рамки для вашего процесса. Шаблоны описывают роль, формат ответа и правила, поэтому модель выдаёт предсказуемый результат по вашим задачам.
Ограничение контекстных окон
Ограничение контекстных окон выстраивает динамические рамки под текущие лимиты провайдеров и бюджет проекта. Механизм держит контекст в границах, поэтому вы контролируете расход токенов и сохраняете качество ответов.
Сквозной трейсинг цепочек
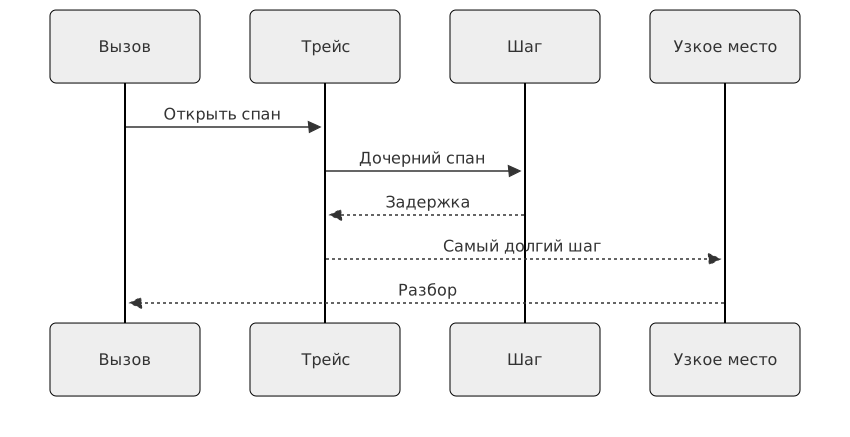
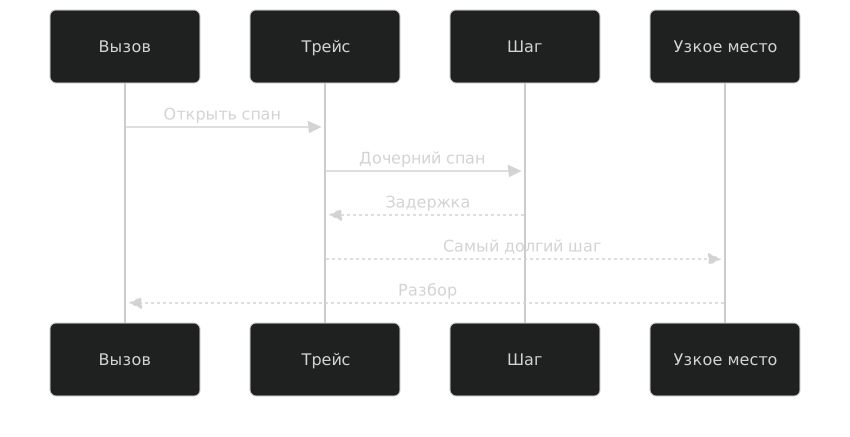
Сквозной трейсинг цепочек вызовов показывает путь каждого ответа и задержки на шагах. Мы включаем распределённую трассировку, поэтому вы находите узкое место в цепочке и держите задержки под контролем.
Аудит стоимости токенов
Аудит стоимости токенов считает расход по каждому шагу и прогнозирует нагрузку по неделям. Мы настраиваем автоматический аудит, поэтому вы видите бюджет в цифрах и заранее замечаете рост расходов на моделях.








Технологии
Технологии, которые мы используем в работе, и их роль в проекте.
Векторный слой и семантика
Для работы со сложными массивами знаний разворачиваются производительные векторные базы данных Qdrant или специализированные расширения pgvector для PostgreSQL. Преобразование неструктурированных документов в математические векторы высокой размерности оптимизируется через изолированные Embeddings API, исключающие рассинхронизацию индексов.
Оркестрация и обсервабилити
Управление контекстными окнами и гибридный поиск осуществляются на базе легковесных нативных прослоек. Мониторинг стоимости запросов, логирование промптов и отладка цепочек вызовов в реальном времени интегрируются через Langfuse, что гарантирует прозрачность операционных затрат.
Калькулятор стоимости
Это ориентировочный диапазон, а не коммерческое предложение. Точную смету подготовим после брифа: она зависит от объёма и числа интеграций.
Узлы
Класс GPU
Хранилище
Дополнительно
Поддержка
Первый год: обновления и мониторинг, ответ за 2 рабочих дня.
Услуга
Проектирование ИИ-инфраструктуры
В смету входит работа команды. Оборудование, лицензии сторонних сервисов и командировки добавляем по согласованию.
Расчётная стоимость
3,7 млн. ₽
Срок работ
8 нед.
Частые вопросы
Как архитектура защищает систему от галлюцинаций?
Модель изолируется в рамках предоставленного RAG-контекста, извлеченного из векторной базы данных. Ей запрещается использовать скрытые веса обучения для генерации фактов, а prompt-инструктор блокирует ответ, если релевантные фрагменты текста не найдены локально.
Каким образом семантическое кэширование снижает операционные затраты?
Внедрение семантического кэша на уровне инфраструктуры перехватывает большинство повторных обращений, определяя близость смысла вопросов из оперативной памяти. Это избавляет от необходимости повторно отправлять тяжелые контексты во внешние LLM-сервисы.
Как обеспечивается безопасность коммерческой тайны?
Вся векторная база данных, парсеры документов и поисковые движки разворачиваются в защищенном приватном контуре клиента. Внешние API инференса получают только обезличенные и изолированные текстовые фрагменты, очищенные от персональной информации.
С чего начинается проект?
Проект начинается с аудита данных: какие источники есть, кто владелец и как часто они меняются. По результатам выбираем схему чанков, метаданных и поиска.
Что берут вместе с этой услугой
Связанные услуги
Примеры внедрений
×4,5
Скорость обработки потоковых данных
Готовы обсудить задачу?
Оставьте заявку – вернёмся с предложением и предварительной оценкой.
Связаться с нами