 Login AI
Проектирование высоконагруженных бэкенд-систем
Проектируем и пишем серверные системы, которые держат нагрузку без деградации: снимаем профили и убираем узкие места в базах, сетевом вводе-выводе и сериализации. Отдельно считаем, во сколько обходится ваша текущая архитектура в серверах и что меняется после переноса контуров на асинхронный рантайм.
Инженерные решения для распределённых систем с миллионными потоками данных и жёсткими требованиями к времени ответа.
Стоимость
от 2 500 000 ₽
за проект
Это нижняя граница проекта. Точную смету считаем после брифа: она зависит от объёма и числа интеграций.
Возможности
Пропускная способность
Держим сотни тысяч одновременных соединений на одном сервере: обработка идёт конкурентно, поэтому ядра не простаивают в ожидании сети.
Экономия инфраструктуры
Переносим контуры в нативный код и загружаем процессоры плотнее, а не добавляем машины. Тот же трафик обслуживаем меньшим числом серверов, и разницу показываем в смете до старта работ.
Безопасность памяти
Компилятор отсекает обращения к освобождённой памяти и гонки данных на этапе сборки. Сервис не падает из-за ошибки, которую не нашёл ни один тест.
Предсказуемое время ответа
Замеряем хвосты задержек, а не среднее: 99-й перцентиль остаётся в заявленном коридоре даже в момент пикового всплеска.
От заявки до результата
1
Профильный аудит
Снимаем профиль работающей системы: распределение памяти, сетевые ожидания, самые медленные запросы. Замеры идут на реальной нагрузке, а не на синтетике в стенде.
2
Проектирование ядра
Собираем асинхронные неблокирующие контуры, разводим чтение и запись и задаём границы отказов: что система отдаёт клиенту, когда зависимость лежит.
3
Оптимизация хранения
Настраиваем репликацию и шардирование, выносим отчётность в аналитическую СУБД, чтобы тяжёлые запросы не блокировали транзакции.
4
Стресс-тестирование
Имитируем всплески выше рабочего максимума и фиксируем задержки на хвостах. Результат – числа, по которым вы сравниваете нашу версию со своей, а не обещание «выдержит».
Проверьте, подойдёт ли вам
Подходит
Финтех-сервисы
Тысячи транзакций в минуту и договорной уровень обслуживания на время ответа, который нельзя нарушить. Мы считаем задержку на хвостах, а не среднюю, и приводим её к заявленному коридору.
IoT-платформы
Данные с датчиков приходят постоянно, и потерянный пакет – это потерянное событие, а не строчка в логе. Канал обработки держим неблокирующим, чтобы задержка не копилась в очереди.
Высоконагруженный SaaS
Интерфейс тормозит под нагрузкой, хотя железо ещё не упирается в лимиты. Обычно виноваты обращения к базе на каждую строку списка, и мы находим их профилированием, а не закупкой машин помощнее.
Пайплайны агрегации
Вы собираете данные из тысяч источников и считаете агрегаты потоково. Разводим контур сбора, контур хранения и контур отчётности, чтобы тяжёлый отчёт не блокировал запись новых данных.
Не подходит
Ранние MVP стартапов
Вы проверяете гипотезу, а не оптимизируете рантайм. Нативный стек удлиняет путь до первой функции, и если проверка не оправдается, это время уже не вернуть.
Простые CRUD-системы
Админка, визитка или портал без фоновых вычислительных задач. Управляемого рантайма там достаточно, и переход на нативный код не даст выигрыша, который можно измерить.
Замкнутые legacy-контуры
Система построена вокруг частых вызовов закрытых C-библиотек без стабильного интерфейса. Обвязка таких вызовов съедает смысл перехода, и сначала придётся договариваться с вендором.
Редкие сетевые запросы
Сервис делает десятки изолированных обращений в сутки. Асинхронный рантайм там не нужен, а стандартное решение имеет заметно более низкий порог входа.
Что вы получаете
×4,5
скорость обработки потоковых данных
Перенесли потоковый контур сбора и обработки отзывов с виртуальных машин на асинхронный рантайм. Прирост дали загруженные процессоры и отсутствие пауз на очистку памяти, а не смена языка сама по себе; целевое время ответа при пиковом наплыве удержалось.
100 000+ соединений
Асинхронный рантайм
Асинхронный рантайм держит сотни тысяч одновременных соединений на одном сервере, поэтому каждое ядро занято обработкой.
Меньше машин
Экономия серверов
Экономия серверов идёт от загруженных процессоров: тот же трафик обслуживается меньшим числом машин, и разницу считаем на ваших профилях.
99-й перцентиль
Задержка на хвостах
Замеряем хвосты задержек, а 99-й перцентиль остаётся в заявленном коридоре даже в момент пикового всплеска.
Ошибки в сборке
Безопасность памяти
Компилятор отсекает обращения к освобождённой памяти и гонки данных на этапе сборки, поэтому часть ошибок ловится до продакшена.
Проверка до старта
Профиль памяти по аллокациям
Профиль памяти снимаем по аллокациям, а не только по занятому объёму: видно, какой модуль удерживает память между запросами. Так находятся утечки в долгоживущих процессах – на синтетическом тесте их обычно нет, потому что воркеры там живут минуты.
Сетевые ожидания отдельно
Сетевые ожидания меряем отдельно от вычислений. Если процессор занят на 4%, а время ответа растёт, узкое место в вводе-выводе или в разблокировках, и настройки операционной системы и пула соединений дают больше, чем переезд на другое железо.
Медленные SQL по плану
Медленные SQL-запросы находим по журналу и плану выполнения, а не по жалобам пользователей. Блокировка таблицы на 400 мс в пиковом окне превращается в очередь на минуты, когда через неё проходит транзакционный поток.
Стратегия деградации
Стратегию деградации задаём до написания кода: какие функции можно урезать, какие экраны отдавать из кэша, а где честнее вернуть ошибку, чем показать зависшие данные. Поведение под нагрузкой должно задаваться вами, а не оставаться на волю таймаутам.
Распределённая трассировка
Распределённую трассировку внедряем, чтобы увидеть, где именно теряется время: в сети, в очереди, в базе или в сериализации. Без этого отчёт о медленном ответе начинается с догадок.
Сериализация отдельной задачей
Сериализацию оптимизируем отдельной задачей: под нагрузкой объём JSON заметно меняет стоимость запроса. Компактный формат и разбор без лишних копий освобождают процессор, который иначе уходит на упаковку данных.
Механизм работы
Репликация чтения с копий
Репликацию настраиваем так, чтобы чтение шло с копий, а запись оставалась на мастере. Тогда долгие выборки перестают конкурировать с транзакциями за одни и те же блокировки.
Кэширование делаем многоуровневым
Кэширование делаем многоуровневым: частое чтение остаётся в памяти процесса, а повторные обращения к дорогому внешнему вызову уходят в общий Redis. Сначала смотрим, какие запросы повторяются, и только потом задаём сроки годности, иначе кэш начинает отдавать устаревшие ответы.
Шардирование планируем заранее
Шардирование планируем до того, как упрёмся в физические лимиты, и подбираем ключ, по которому данные одного клиента попадают на один шард. Неверный ключ превращает точечный запрос в обход всей таблицы.
Очереди сообщений делаем отказоустойчивыми
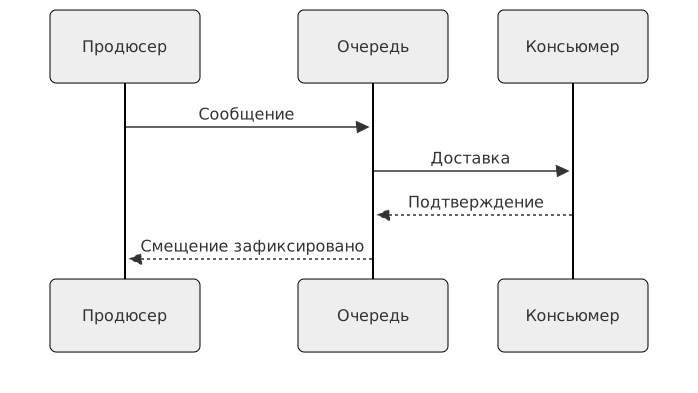
Очереди сообщений делаем отказоустойчивыми: подтверждение после записи результата и повтор доставки при сбое потребителя. Тяжёлая фоновая задача тогда выполняется ровно один раз, и это мы проверяем под нагрузкой на реальном стенде.
Переключение на резервные узлы автоматизируем
Переключение на резервные узлы автоматизируем с проверкой ролей и задержкой в секунды. Плановое обслуживание базы перестаёт быть событием в календаре, о котором предупреждают за неделю.
Индексы в аналитической СУБД
Индексы в аналитической СУБД настраиваем под конкретные отчёты, по факту замеров: лишний индекс замедляет запись и расходует память. Сначала меряем, во сколько обходится тяжёлая отчётность, и только потом решаем, выносить ли её в отдельный контур.




Технологии
Технологии, которые мы используем в работе, и их роль в проекте.
Асинхронный рантайм
Сервисы пишем на Rust с многопоточным асинхронным рантаймом Tokio. Строгий контроль владения памятью и отсутствие пауз на очистку мусора убирают непредсказуемые задержки под нагрузкой, а сетевой слой на Axum держит тысячи одновременных соединений на одном процессе.
Распределённые хранилища
Транзакционные задачи закрывает кластер PostgreSQL с ограниченным пулом соединений. Кэш и очереди берут на Redis, агрегаты по большим объёмам считает ClickHouse, а полнотекстовый поиск ведёт Elasticsearch.
Калькулятор стоимости
Это ориентировочный диапазон, а не коммерческое предложение. Точную смету подготовим после брифа: она зависит от объёма и числа интеграций.
Срок, месяцев
Сложность
Мульти-регион и HA
Дополнительно
Поддержка
Первый год: обновления и мониторинг, ответ за 2 рабочих дня.
Услуга
Проектирование высоконагруженных бэкенд-систем
В смету входит работа команды. Оборудование, лицензии сторонних сервисов и командировки добавляем по согласованию.
Расчётная стоимость
5,3 млн. ₽
Срок работ
23 нед.
Частые вопросы
Как архитектура держит пиковую нагрузку без просадки скорости?
Запросы обрабатываются конкурентно на пуле потоков, а сетевое ожидание не занимает поток: пока сервис ждёт ответа базы, он берёт следующий запрос. В такой модели нет пауз на очистку памяти, поэтому задержки на 99-м перцентиле остаются в коридоре даже при резком наплыве пользователей.
Как переход на асинхронный бэкенд снижает расходы на серверы?
Прямой эффект даёт загрузка процессоров: вместо ожидания сети поток занимается задачей, и на том же железе обслуживается больше трафика. На практике это означает меньше машин под тот же уровень обслуживания. Точную цифру считаем на ваших профилях нагрузки, потому что без ваших данных любое «в десять раз» будет догадкой.
Что происходит с системой, когда база данных тормозит или падает?
В контур сетевых стримов включается обратное давление: при замедлении зависимости запросы буферизуются в очередях, а дальше срабатывает автоматический разрыв цепи. Часть функций при этом уходит в режим деградации, но система не разваливается лавинообразно, и клиент получает внятный ответ вместо таймаута в обслужную сеть.
Что нужно от вашей команды?
Доступ к профилям нагрузки и метрикам: распределение запросов, хвосты времени ответа и конфигурацию хранилищ. По ним находим узкие места, а проверки ведём на стенде до выкатки в прод.
Что берут вместе с этой услугой
В составе решений
Примеры внедрений
×4,5
Скорость обработки потоковых данных
Готовы обсудить задачу?
Оставьте заявку – вернёмся с предложением и предварительной оценкой.
Связаться с нами