 Login AI
Развёртывание суверенных моделей в вашем контуре
Разворачиваем открытые LLM в вашем контуре: подбор железа, квантизация, изоляция данных и режим без внешних API. Точность сопоставима с облаком на типовых задачах.
Открытые модели работают на вашем железе, данные остаются внутри контура.
Стоимость
от 3 000 000 ₽
за проект
Это нижняя граница проекта. Точную смету считаем после брифа: она зависит от объёма и числа интеграций.
Возможности
Данные внутри контура
Запросы и документы не уходят внешнему провайдеру: модель работает на вашем железе.
Подбор железа
Считаем GPU, память и пропускную способность под модель и пиковую нагрузку, без запаса на глаз.
Квантизация
Сжимаем модель под доступную память и замеряем просадку качества на ваших задачах.
Резервный контур
При перегрузке запрос уходит в облако по правилам, а не падает с ошибкой.
От заявки до результата
1
Аудит требований
Фиксируем модель, задачи и ограничения: где нужна точность, а где достаточно скорости.
2
Подбор железа
Подбираем GPU и память под модель и нагрузку, считаем стоимость владения против облака.
3
Развёртывание
Поднимаем инференс, настраиваем изоляцию и наблюдаемость, закрываем внешние вызовы.
4
Замеры качества
Сравниваем локальную модель с облачной на вашем наборе задач и фиксируем просадку.
Проверьте, подойдёт ли вам
Подходит
Данные нельзя выносить
Регуляторные или коммерческие ограничения запрещают внешний API: модель остаётся внутри.
Предсказуемая нагрузка
Пик известен: железо подбирается под него, а не под абстрактный максимум.
Не подходит
Нужна последняя frontier-модель
Если задача требует модели, которой нет в открытом доступе, локальный вариант не подойдёт.
Нет GPU и площадки
Без выделенного железа развёртывание превращается в отдельный инфраструктурный проект.
Что вы получаете
0
запросов к внешнему API
Запросы и внутренние документы обрабатывались локальной моделью; внешние вызовы из контура исключены.
Без внешних вызовов
Данные в периметре
Документы, переписка и запросы обрабатываются на вашем железе. Данные остаются в периметре, поэтому внешние вызовы исчезают.
Амортизация железа
Предсказуемая стоимость
Счёт за токены заменяет амортизация железа и электричество. Стоимость становится предсказуемой и держится ровной при пиковой нагрузке.
Локальная сеть
Задержка без провайдера
Модель отвечает из локальной сети, поэтому задержка перестаёт зависеть от провайдера. Сетевой джиттер исчезает.
Плановое обновление
Контроль версии
Обновление модели планируют и тестируют на своём наборе задач. Контроль версии остаётся за вами, и прод идёт по плану.
Что входит в поставку
Аудит задач и модели
Аудит задач и модели показывает, где нужна максимальная точность, а где хватает скорости. Выбор конфигурации опирается на факты.
Подбор железа
Считаем GPU, память и пропускную способность под модель и пиковую нагрузку. Подбор железа задаёт потолок производительности.
Квантизация и замер
Сжимаем веса под доступную память и меряем просадку на ваших задачах. Квантизация и замер показывают цену сжатия.
Контур изоляции
Закрываем внешние вызовы, настраиваем права, журналы и резервные реплики. Контур изоляции держит данные внутри.
Приёмка
Сравниваем с облачной моделью на вашем наборе и передаём метрики команде. Приёмка подтверждает результат до старта эксплуатации.
Механизм работы
Изоляция периметра
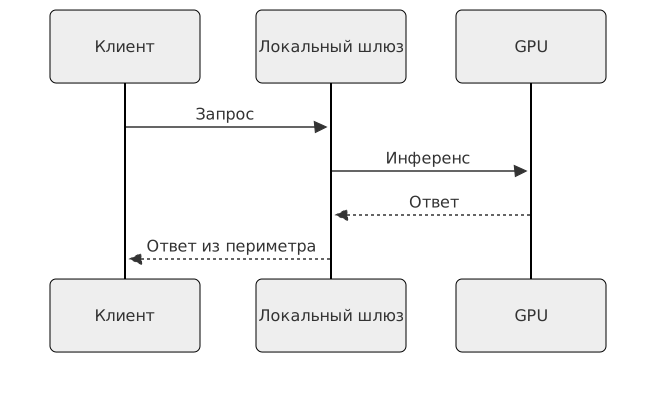
Документы, переписка и запросы обрабатываются на вашем железе внутри периметра. Наружу уходят только согласованные метрики, поэтому вы сохраняете контроль над данными и журналами доступа.
Локальный инференс
Инференс идёт из внутренней сети, поэтому ответ приходит с задержкой локальной сети. Провайдер внешнего канала и его джиттер остаются в стороне, а вы получаете ровное время отклика под нагрузкой.
Квантизация под железо
Квантизация сжимает веса под доступную память карты и добавляет просадку качества. Просадку замеряем на ваших задачах, поэтому вы видите реальную цену сжатия на своём наборе данных.
Обновление по плану
Обновление модели тестируют на своём наборе и выводят канареечно по плану. Прод получает предсказуемые изменения, а вы контролируете версию и момент выката.




Где решение упирается
- 01
Открытые модели отстают на рассуждениях
Открытые модели отстают от frontier на сложных рассуждениях: там, где нужна максимальная точность, локальный вариант проигрывает.
- 02
Простой GPU останавливает контур
Железо и его обслуживание — ваша зона: простой GPU останавливает весь контур, и резерв нужно планировать.
- 03
Квантизация снижает качество
Квантизация экономит память и добавляет просадку качества: замер идёт на ваших данных, потому что на чужих наборах просадка выглядит иначе.
- 04
Обновление модели — проект
Обновление модели — отдельный проект: переобучение промптов, повторные замеры и канареечный вывод идут последовательными этапами.
- 05
Стоимость железа
Стоимость железа считаем заранее, вместе с резервом и простоями. Владение железом включает запас мощности на пиковую нагрузку.
- 06
Электричество и охлаждение
На длинной дистанции электричество и охлаждение дают заметную долю счёта. Электричество и охлаждение считаем вместе со стоимостью владения.
- 07
Обновления модели
Перенос промптов и повторные замеры при обновлении модели идут отдельным проектом. Обновления модели считаем отдельной строкой бюджета.
- 08
Эксплуатация контура
Мониторинг, дежурство и реакция на отказ GPU ложатся на вашу команду. Эксплуатация контура требует людей и процесса поддержки.
Технологии
Технологии, которые мы используем в работе, и их роль в проекте.
Модели и запуск
Открытые модели Qwen и Llama запускаются на vLLM внутри Kubernetes, состояние и кэш хранятся в PostgreSQL.
Калькулятор стоимости
Это ориентировочный диапазон, а не коммерческое предложение. Точную смету подготовим после брифа: она зависит от объёма и числа интеграций.
Узлы
Размер модели
Fine-tuning
Дополнительно
Поддержка
Первый год: обновления и мониторинг, ответ за 2 рабочих дня.
Услуга
Развёртывание суверенных моделей в вашем контуре
В смету входит работа команды. Оборудование, лицензии сторонних сервисов и командировки добавляем по согласованию.
Расчётная стоимость
4 млн. ₽
Срок работ
8 нед.
Частые вопросы
Точность будет как в облаке?
На типовых задачах — да, на сложных рассуждениях открытые модели слабее. Мы показываем замеры до выбора.
Какое железо нужно?
Зависит от модели и нагрузки: от одной GPU для пилота до кластера под поток. Конфигурацию считаем заранее.
Можно смешать локально и облако?
Да. Простые и закрытые запросы идут локально, сложные — в облако по правилам и с обезличиванием.
Сколько занимает запуск?
Пилот на одной GPU — две-три недели, продакшн-контур — от восьми недель.
Кто отвечает за железо?
Вы владеете контуром и железом, мы отвечаем за архитектуру и запуск. Обслуживание и резерв можно передать нам отдельным договором.
Что с обновлениями модели?
Обновление — отдельный проект: переносим промпты, повторяем замеры и выводим новую версию канареечно, а не меняем веса в ночь.
Что берут вместе с этой услугой
Готовы обсудить задачу?
Оставьте заявку – вернёмся с предложением и предварительной оценкой.
Связаться с нами