 Login AI
Разработка детерминированных RAG-систем
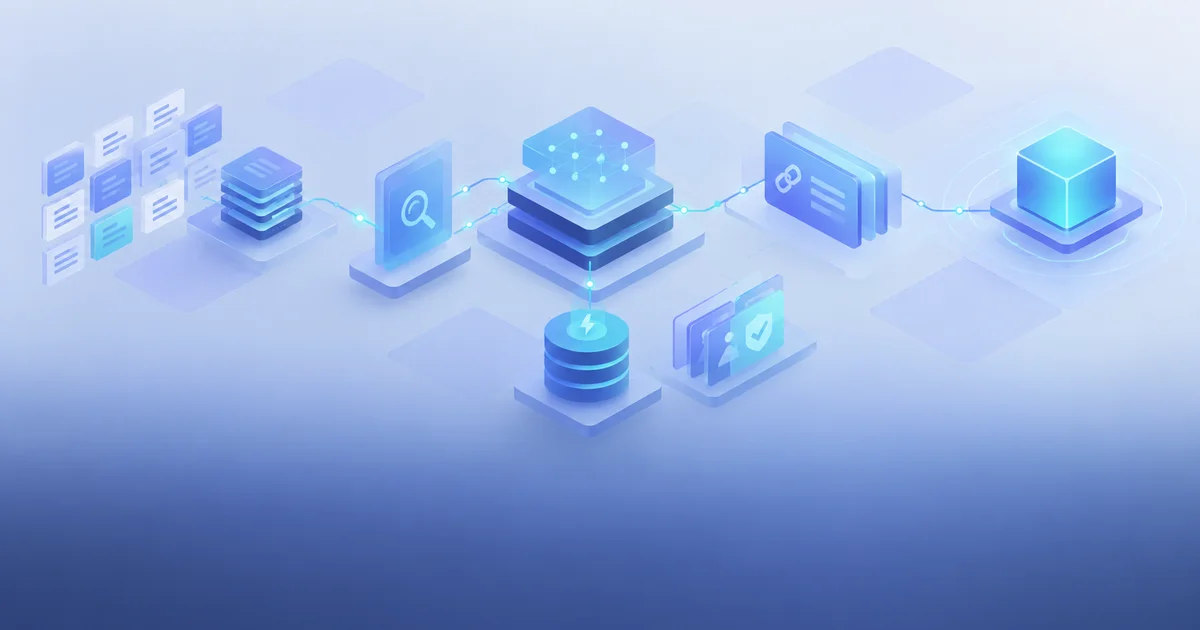
Собираем RAG-контур с гибридным поиском, семантическим кэшем и трассировкой: модель получает только верифицированные фрагменты, каждый ответ прослеживается до источника.
Модель отвечает по 3–4 проверенным фрагментам и ссылается на источник.
Стоимость
от 1 500 000 ₽
за проект
Это нижняя граница проекта. Точную смету считаем после брифа: она зависит от объёма и числа интеграций.
Возможности
Гибридный поиск
Смысл и точные идентификаторы — артикулы, даты, имена — ищутся вместе, а не по отдельности.
Проверяемый источник
Каждый ответ ссылается на конкретный фрагмент; без источника система помечает ответ как ответ из памяти.
Семантический кэш
Повторные вопросы отвечают мгновенно, а версия кэша сбрасывается при обновлении документа.
Обезличивание на выходе
Наружу уходят фрагменты без персональных данных, и это видно в логах трассировки.
От заявки до результата
1
Аудит знаний
Разбираем источники, структуру и права доступа: что вообще можно отдавать модели.
2
Схема чанков
Режем документы по структуре и фиксируем метаданные: версия, источник, права.
3
Сборка контура
Поднимаем гибридный поиск, кэш и трассировку, закрываем внешние вызовы обезличиванием.
4
Замеры качества
Меряем долю ответов со ссылкой на источник и точность извлечения на вашем наборе вопросов.
Проверьте, подойдёт ли вам
Подходит
Большой архив документов
Регламенты, договоры и история обращений не помещаются в контекст, но нужны для ответов.
Частые повторные вопросы
Одни и те же темы возвращаются: семантический кэш снимает нагрузку с внешнего инференса.
Не подходит
Документы меняются каждый день
При ежедневной перестройке индекса кэш и версии требуют отдельного конвейера — это другой объём.
Нет владельца базы знаний
Если за источники никто не отвечает, устаревшие документы попадают в ответы наравне со свежими.
Что вы получаете
70–80%
запросов из семантического кэша
Ответы шли со ссылкой на конкретный раздел регламента, а повторные вопросы закрывал кэш.
Что входит в поставку
Аудит источников
Аудит источников показывает, какие документы есть, кто владелец и как часто они меняются. Актуальность базы становится управляемой.
Схема чанков и метаданных
На каждый фрагмент задаём структуру, версию и права доступа. Схема чанков и метаданных держит поиск предсказуемым.
Гибридный поиск и кэш
Векторный и полнотекстовый поиск работают вместе, а порог кэша задаётся отдельно. Гибридный поиск повышает шанс точного ответа.
Трассировка и обезличивание
Путь ответа виден в логах, а персональные данные убираются на выходе. Трассировка и обезличивание идут вместе с фильтрами.
Замеры на ваших вопросах
Считаем долю ответов со ссылкой и точность извлечения на вашем наборе вопросов. Замеры показывают реальное качество до запуска.
Механизм работы
Офлайн-индексация
Документы индексируются офлайн, поэтому качество ответа держится стабильным при любом текущем трафике. Задержка внешнего канала на качество такого ответа уже влияет слабо.
Гибридный поиск
Гибридный поиск закрывает обе ошибки: векторный пропускает артикул, полнотекстовый пропускает синоним, а вместе они ловят и точное совпадение, и смысл.
Трассировка ответа
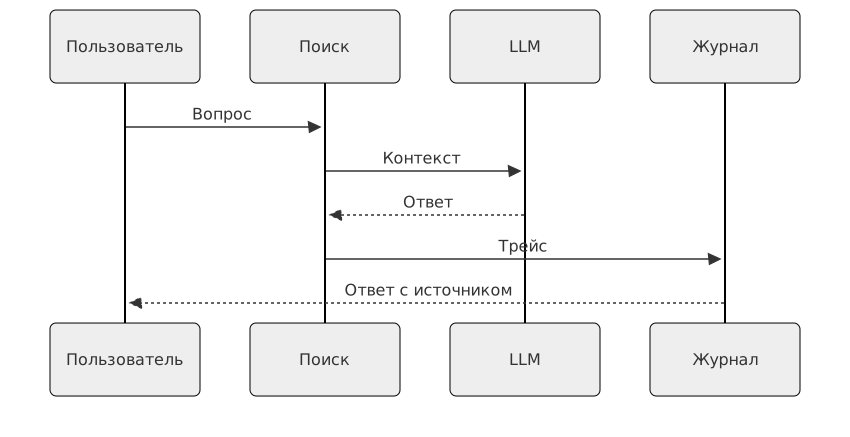
Трассировка показывает путь ответа: какой фрагмент найден, сколько стоил запрос и на каком шаге потерялся источник. По этой цепочке видно каждое звено и точку сбоя.
Версии по событию
Версии индекса переключаются по событию: обновление регламента запускает переиндексацию только изменённой части архива, а весь остальной массив остаётся в прежней версии.




Где решение упирается
- 01
Разбиение решает многое
Разбиение решает многое: слишком мелкий чанк рвёт контекст, крупный размывает внимание модели, и оба варианта дают неверный ответ.
- 02
Кэш отдаёт похожий ответ
Семантический кэш может отдать прошлый ответ на близкий по вектору вопрос: порог держат высоким, а попадания логируют.
- 03
Шаблонное обезличивание
Обезличивание работает на шаблонах: регулярные выражения ловят почту и телефоны, а свободный текст требует выборочной проверки. Полную гарантию метод даёт для структурированных полей.
- 04
Права доступа в метаданных
Права доступа хранятся в метаданных фрагмента: без них поиск отдаёт и те документы, которые закрыты для этого пользователя.
- 05
Владелец базы знаний
За актуальность источников отвечает владелец базы знаний. Владелец базы знаний задаёт правила пополнения, иначе база устаревает.
- 06
Права доступа
Права доступа определяют, кто какие документы видит. Права доступа заданы заранее, иначе поиск отдаёт документы, закрытые для пользователя.
- 07
Качество исходников
Сканы без текстового слоя и дубли снижают точность извлечения. Качество исходников определяет потолок точности всей системы.
- 08
Регламент обновления
Регламент обновления задаёт событие, по которому пересобирается версия индекса. Регламент держит индекс свежим и фиксирует ответственного.
Технологии
Технологии, которые мы используем в работе, и их роль в проекте.
Поиск и наблюдаемость
Поиск строится на Qdrant или pgvector, цепочку шагов собирает Langfuse, обновления документов идут через Kafka, а версии индекса хранятся в PostgreSQL.
Калькулятор стоимости
Это ориентировочный диапазон, а не коммерческое предложение. Точную смету подготовим после брифа: она зависит от объёма и числа интеграций.
Источники данных
Retrieval
Оценка качества
Дополнительно
Поддержка
Первый год: обновления и мониторинг, ответ за 2 рабочих дня.
Услуга
Разработка детерминированных RAG-систем
В смету входит работа команды. Оборудование, лицензии сторонних сервисов и командировки добавляем по согласованию.
Расчётная стоимость
2,1 млн. ₽
Срок работ
6 нед.
Частые вопросы
Чем это отличается от обычного RAG?
Мы не отправляем весь архив в контекст: модель получает 3–4 верифицированных фрагмента и ссылку на источник.
Что если нужного фрагмента нет?
Система помечает ответ как ответ из памяти, а не выдаёт его за найденный в документах.
Как часто пересобирать индекс?
По событию: новая редакция документа запускает пересборку версии, а не всего архива целиком.
Данные уходят наружу?
Только обезличенные фрагменты; парсинг, индексация и поиск остаются внутри контура.
Можно подключить несколько источников?
Да, коннекторы собирают документы из нескольких систем, а права проверяются на уровне метаданных фрагмента.
Что с эксплуатацией?
Основная стоимость — внешний инференс на ответах, которых нет в кэше. Пересборка идёт по событию, а не по расписанию, поэтому платите за реальные изменения.
Что берут вместе с этой услугой
Готовы обсудить задачу?
Оставьте заявку – вернёмся с предложением и предварительной оценкой.
Связаться с нами